01.
Latencia Cero
Al eliminar la dependencia de nubes externas, reducimos el tiempo de respuesta en el procesamiento de prompts visuales complejos en un 40%. La transferencia de datos ocurre en buses internos de alta velocidad.
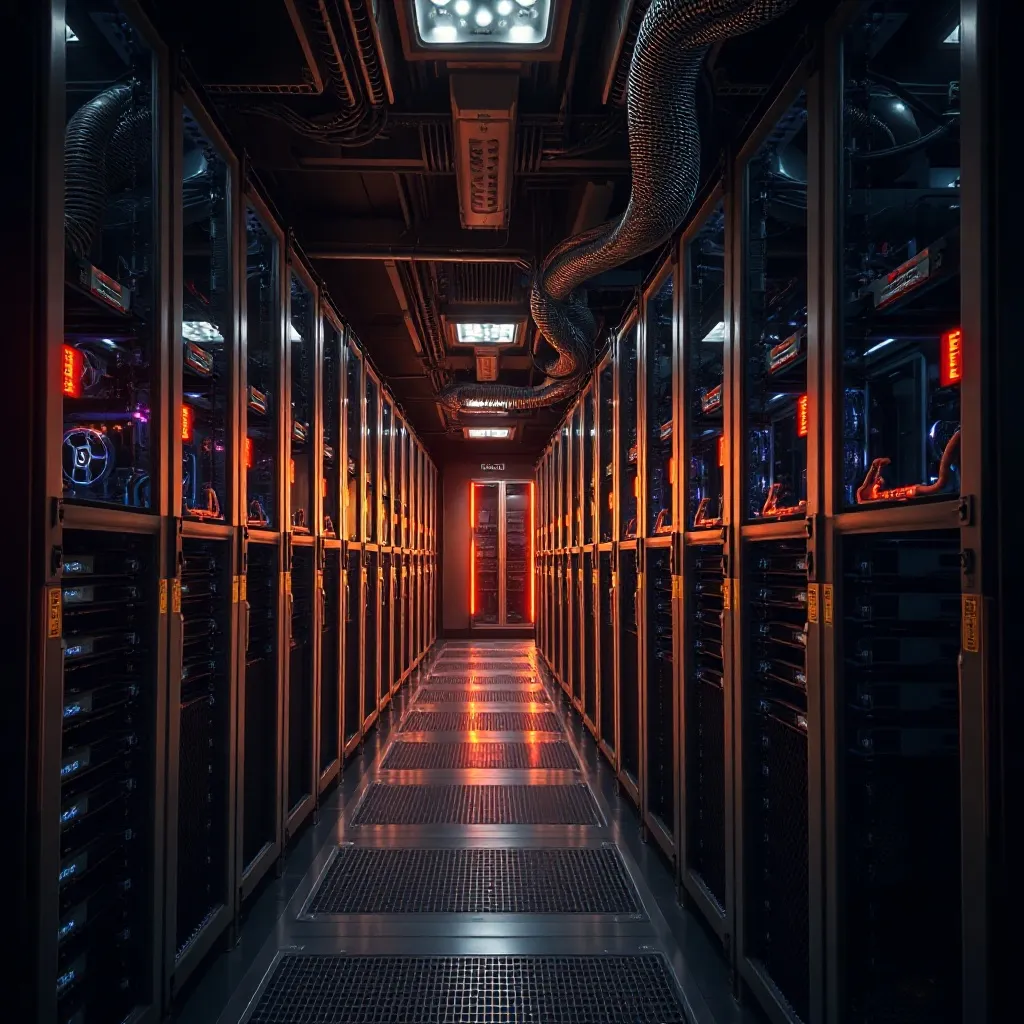
Nuestros laboratorios operan bajo una arquitectura de hardware dedicada. El análisis de redes neuronales requiere una asignación mínima de 24GB de VRAM por nodo para evitar cuellos de botella en la fase de inferencia masiva.
Al eliminar la dependencia de nubes externas, reducimos el tiempo de respuesta en el procesamiento de prompts visuales complejos en un 40%. La transferencia de datos ocurre en buses internos de alta velocidad.
El cumplimiento estricto de nuestra política de privacidad se garantiza mediante el almacenamiento físico local, impidiendo fugas de información hacia servidores de terceros.
La configuración modular permite la integración de nuevas unidades de procesamiento sin interrumpir el ciclo de vida del hardware existente, optimizando el retorno de inversión técnica.
La base de nuestra operación en el Bilbao Visual Tech Lab se sustenta en clusters de servidores optimizados para cargas de trabajo de IA. Cada unidad cuenta con procesadores de 64 núcleos y un sistema de memoria RAM DDR5 de canal cuádruple, permitiendo la manipulación de datasets de gran escala en tiempo real.
NVIDIA RTX 6000 Ada Generation. Configuración multi-GPU con NVLink para un ancho de banda de comunicación entre tarjetas superior a los 600 GB/s.
Matrices NVMe Gen5 en configuración RAID 10, garantizando una integridad de datos absoluta y velocidades de lectura secuencial de hasta 12,000 MB/s.
El control térmico es crítico para mantener la estabilidad del sistema. Implementamos soluciones de enfriamiento líquido de circuito cerrado que mantienen los núcleos de procesamiento por debajo de los 65°C incluso bajo carga sintética del 100%. Este enfoque no solo prolonga la vida útil de los componentes, sino que evita el estrangulamiento térmico (thermal throttling) durante procesos críticos de renderizado.
Nuestra metodología de gestión de activos incluye una auditoría técnica trimestral. Analizamos la degradación de los semiconductores y la eficiencia de las fuentes de alimentación para predecir fallos antes de que ocurran. Este análisis proactivo asegura que los proyectos de nuestros clientes nunca se vean comprometidos por fallos de hardware.
La rotación de hardware se ejecuta cada 24 meses, asegurando que el laboratorio siempre disponga de las últimas innovaciones en aceleración por hardware para IA generativa.
Explorar análisis de datasets asociados
Nuestra infraestructura está preparada para procesar las demandas más exigentes del diseño generativo moderno.